Mi az a kontextusablak és mi az a token? Miért felejti el az AI a beszélgetés elejét – érthetően, technikai zsargon nélkül, 2026-os adatokkal.
Mi az a kontextusablak?
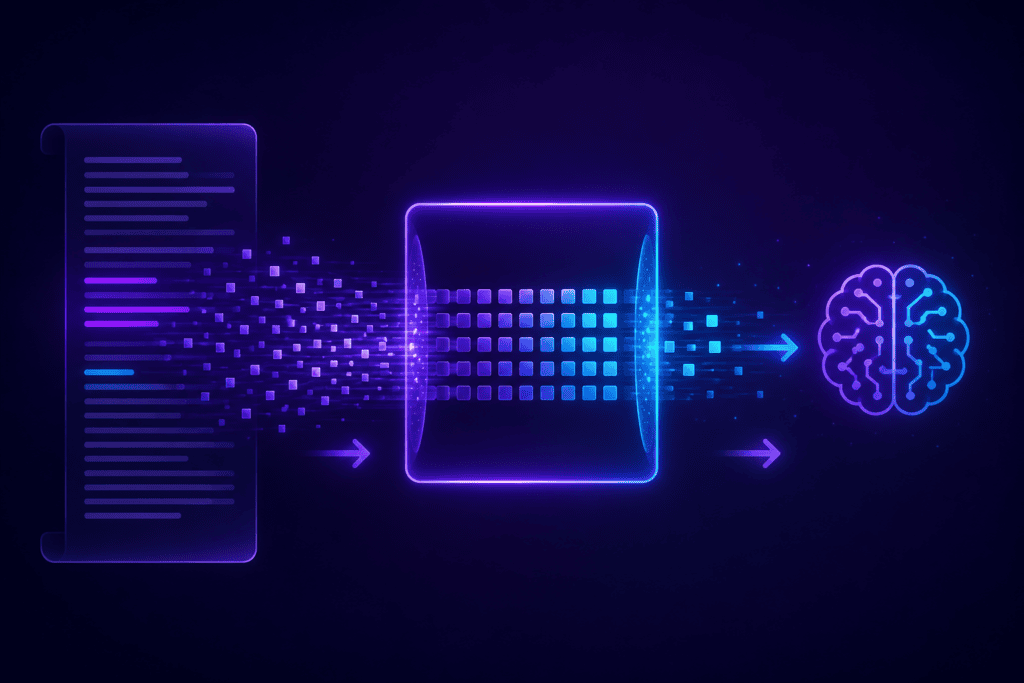
A kontextusablak (angolul context window) az a maximális szövegmennyiség, amit egy AI-modell egyszerre figyelembe tud venni. Gondolj rá úgy, mint egy asztalra: csak annyi papír fér el rajta, amekkora az asztal, és ha újat teszel rá, valami lecsúszik a szélén. Ez a legfontosabb dolog, amit az AI-eszközökről érdemes érteni, mert szinte minden furcsa viselkedés innen ered: hogy egy hosszú beszélgetés végén elfelejti, mit kértél az elején; hogy egy nagy dokumentumnál pontatlanná válik; hogy néha ismételni kezdi magát.
A lényeg, amit a legtöbben félreértenek: a modellnek nincs memóriája a hétköznapi értelemben. Minden egyes válasz előtt újraolvassa az egész beszélgetést, elejétől a végéig. Nem emlékszik – újraolvas. Ami nincs benne az ablakban, az számára nem létezik.
Mi az a token, és miért számolja máshogy a magyar nyelvű szavakat?
A kontextusablakot nem karakterben és nem szóban mérik, hanem tokenben. A token egy szódarab: egy gyakori szó általában egy token, egy ritkább szó több darabra esik szét.
A magyar nyelv drágább
A tokenizálókat túlnyomórészt angol szövegen tanították. Az angol átlagosan 1,2–1,4 tokent használ szavanként, a ragozó nyelvek – köztük a magyar – nagyjából ennek a kétszeresét vagy még többet. Ami nálunk egyetlen szó, az a modell szemében sokszor öt-hat értelmetlen darab. Ennek három gyakorlati következménye van:
- Ugyanaz a tartalom magyarul hamarabb megtölti az ablakot, mint angolul
- Ha API-n keresztül fizetsz, ugyanaz a feladat magyarul többe kerül
- A minőség is romolhat: minél apróbb darabokra esik szét egy nyelv, annál nehezebb a modellnek pontosan dolgozni vele
Ezért érzed néha úgy, hogy ugyanaz az eszköz angolul pontosabb válaszokat ad. Nem képzeled, valóban így van.
Mi minden fér bele a keretbe?
Sokan azt hiszik, hogy a kontextusablak csak a kérdésüknek számolja el. Valójában mindent belekalkulál:
- A rendszerutasítást, amit a szolgáltató állít be, és amit te nem is látsz
- A beszélgetés teljes eddigi előzményét – a te üzeneteidet és az AI válaszait is
- Minden feltöltött fájlt, képet, táblázatot, dokumentumot
- A webes keresési találatokat, ha az eszköz keresett
- És magát a választ is, amit a modell éppen megírt
Az utolsó pont szokta a legtöbb meglepetést okozni: ha az ablak majdnem tele van, egyszerűen nem marad hely egy hosszú válasznak – hiába kérnéd.
Mekkora ma egy kontextusablak?
A gyártók hivatalos dokumentációja szerint 2026 közepén ezek a keretek:
- Claude Opus 5 és Sonnet 5 – 1 millió token, ebből legfeljebb 128 ezer a válasz
- Claude Haiku 4.5 – 200 ezer token, ebből legfeljebb 64 ezer a válasz
- GPT-5.6 (Sol, Terra és Luna) – 1,05 millió token, ebből legfeljebb 128 ezer a válasz
- Gemini – a Google leírása szerint a modellek jelentős része 1 millió vagy annál több tokent kezel
Hogy ez mennyi? Egymillió token angol szövegben durván 700–750 ezer szó, vagyis több ezer könyvoldal – magyarul ugyanez lényegesen kevesebb, a ragozás miatt. Egy fontos figyelmeztetés: ezek az API-ra vonatkozó felső határok. A hétköznapi csevegőfelületeken – főleg az ingyenes csomagokban – gyakran ennél jóval szűkebb a keret, úgyhogy ha számít neked, nézd meg a saját csomagod leírásában.
Mi történik, ha tele az ablak?
Három tipikus viselkedés van, és általában nem nagyon figyelmeztet rá az AI.
- Kiesik az eleje. A legtöbb csevegőfelület némán elhagyja a legrégebbi üzeneteket. Innen ered a klasszikus élmény: „de hiszen az elején megmondtam, hogy magázódjunk”.
- Összefoglalja a régi részt. Egyes eszközök nem dobják el, hanem tömörítik a beszélgetés elejét. A lényeg megmarad, de a részletek – konkrét számok, nevek, pontos megfogalmazások – elvesznek.
- Egyszerűen visszautasítja. API-n és néhány felületen hibaüzenetet kapsz, hogy túl hosszú a kérés.
Miért nem old meg mindent a nagyobb ablak?
- A közepén elveszik. Mérések szerint a modellek a beadott szöveg elejére és végére figyelnek a legmegbízhatóbban. Ami egy hosszú anyag közepén van, arra jóval nagyobb eséllyel nem figyel oda. Ezért nem működik az a stratégia, hogy „bedobom a háromszáz oldalt, majd megtalálja benne”.
- A zaj is helyet foglal. Ha ötven oldalnyi lényegtelen anyagot adsz be a két releváns bekezdés mellé, a modell figyelme szétoszlik. A kevesebb sokszor tényleg több.
- Lassabb és drágább. Minden token időbe telik és pénzbe kerül. Egy majdnem tele ablakkal futó beszélgetés érezhetően lomhább, mint egy friss.
Hogyan hozd ki a legtöbbet a keretből?
- Témaváltásnál kezdj új beszélgetést. Ez a leghatékonyabb egyetlen lépéses megoldás – a régi előzmény nemcsak helyet foglal, hanem félre is viszi a modellt.
- A fontosat tedd a legelejére vagy a legvégére. Soha ne a közepére.
- Ne az egész dokumentumot töltsd fel. Vágd ki azt a fejezetet, ami tényleg kell.
- Hosszú beszélgetésben ismételd meg az utasítást. Ha negyven üzenet után is fontos, hogy rövid válaszokat adjon, mondd el újra.
- Váltás előtt kérj összefoglalót. Ha új beszélgetést nyitsz, kérd meg, hogy foglalja össze a lényeget, és azt másold át indulásnak.
- Ha API-t használsz és sokat, gondold végig az angolt. Ugyanaz a feladat angolul kevesebb tokenbe fér bele.
Három gyakori tévhit
„Az AI megtanulja, amit mondok neki.” Nem – egy beszélgetésen belül látja, azon kívül nem, hacsak nincs külön memóriafunkció bekapcsolva, ami már más technológia.
„A nagyobb ablak okosabb modellt jelent.” Nem: a keret mérete és a modell képessége két külön dolog. Egy nagy ablakú gyors modell simán adhat gyengébb választ, mint egy kisebb ablakú erős modell.
„Ha feltöltök egy fájlt, azt biztosan végigolvassa.” Nem feltétlenül – ha a fájl nem fér bele, az eszköz kereshet benne részletekben. Ilyenkor viszont nem lát rá az egészre egyszerre, és ezt nem mindig mondja meg.
Összefoglalás
- A kontextusablak az AI munkaterülete: minden, amit egyszerre lát
- Tokenben mérik, és a magyar szöveg lényegesen több tokent fogyaszt, mint az angol
- Beleszámít a rendszerutasítás, az előzmény, a feltöltött fájlok és a válasz is
- Ha betelik, a legrégebbi rész általában némán kiesik
- A nagy ablak nem pótolja a jó szervezést – a lényeget tegyük az elejére vagy a végére
Ha egyetlen szokást viszel el ebből a cikkből, legyen ez: új téma, új beszélgetés.
Értesülj az újdonságokról
Új eszközök és cikkek hetente egyszer, spam nélkül.